顺手现在支持 AI 探查网页结构并保存为规则——以思源剪藏和数据库做信息收集为例
TLDR
前期我们提供了一个浏览器插件,在访问网页时,一键剪藏或者提取网页中的信息保存至思源笔记。
现在支持用 AI 探查网页元素,并保存为规则。
一些场景
剪藏的网页无法精确识别正文
剪藏的评论区常常包含了用户头像等杂元素无法提取出干净的评论
从豆瓣电影这类结构化的网页提取名称、导演这类元数据并保存至思源笔记数据库,手动写规则太麻烦
现在支持 AI 解析网页结构,识别字段,并保存为规则。后续即可一键收集!
与 AI 直接解析网页获取元数据不同的是,我们使用 AI 解析网页得到获取元数据的规则,后续一键复用。更快,不再耗 token。
例一:将链滴社区的正文和评论剪藏到思源笔记
一句话说明想达到的效果
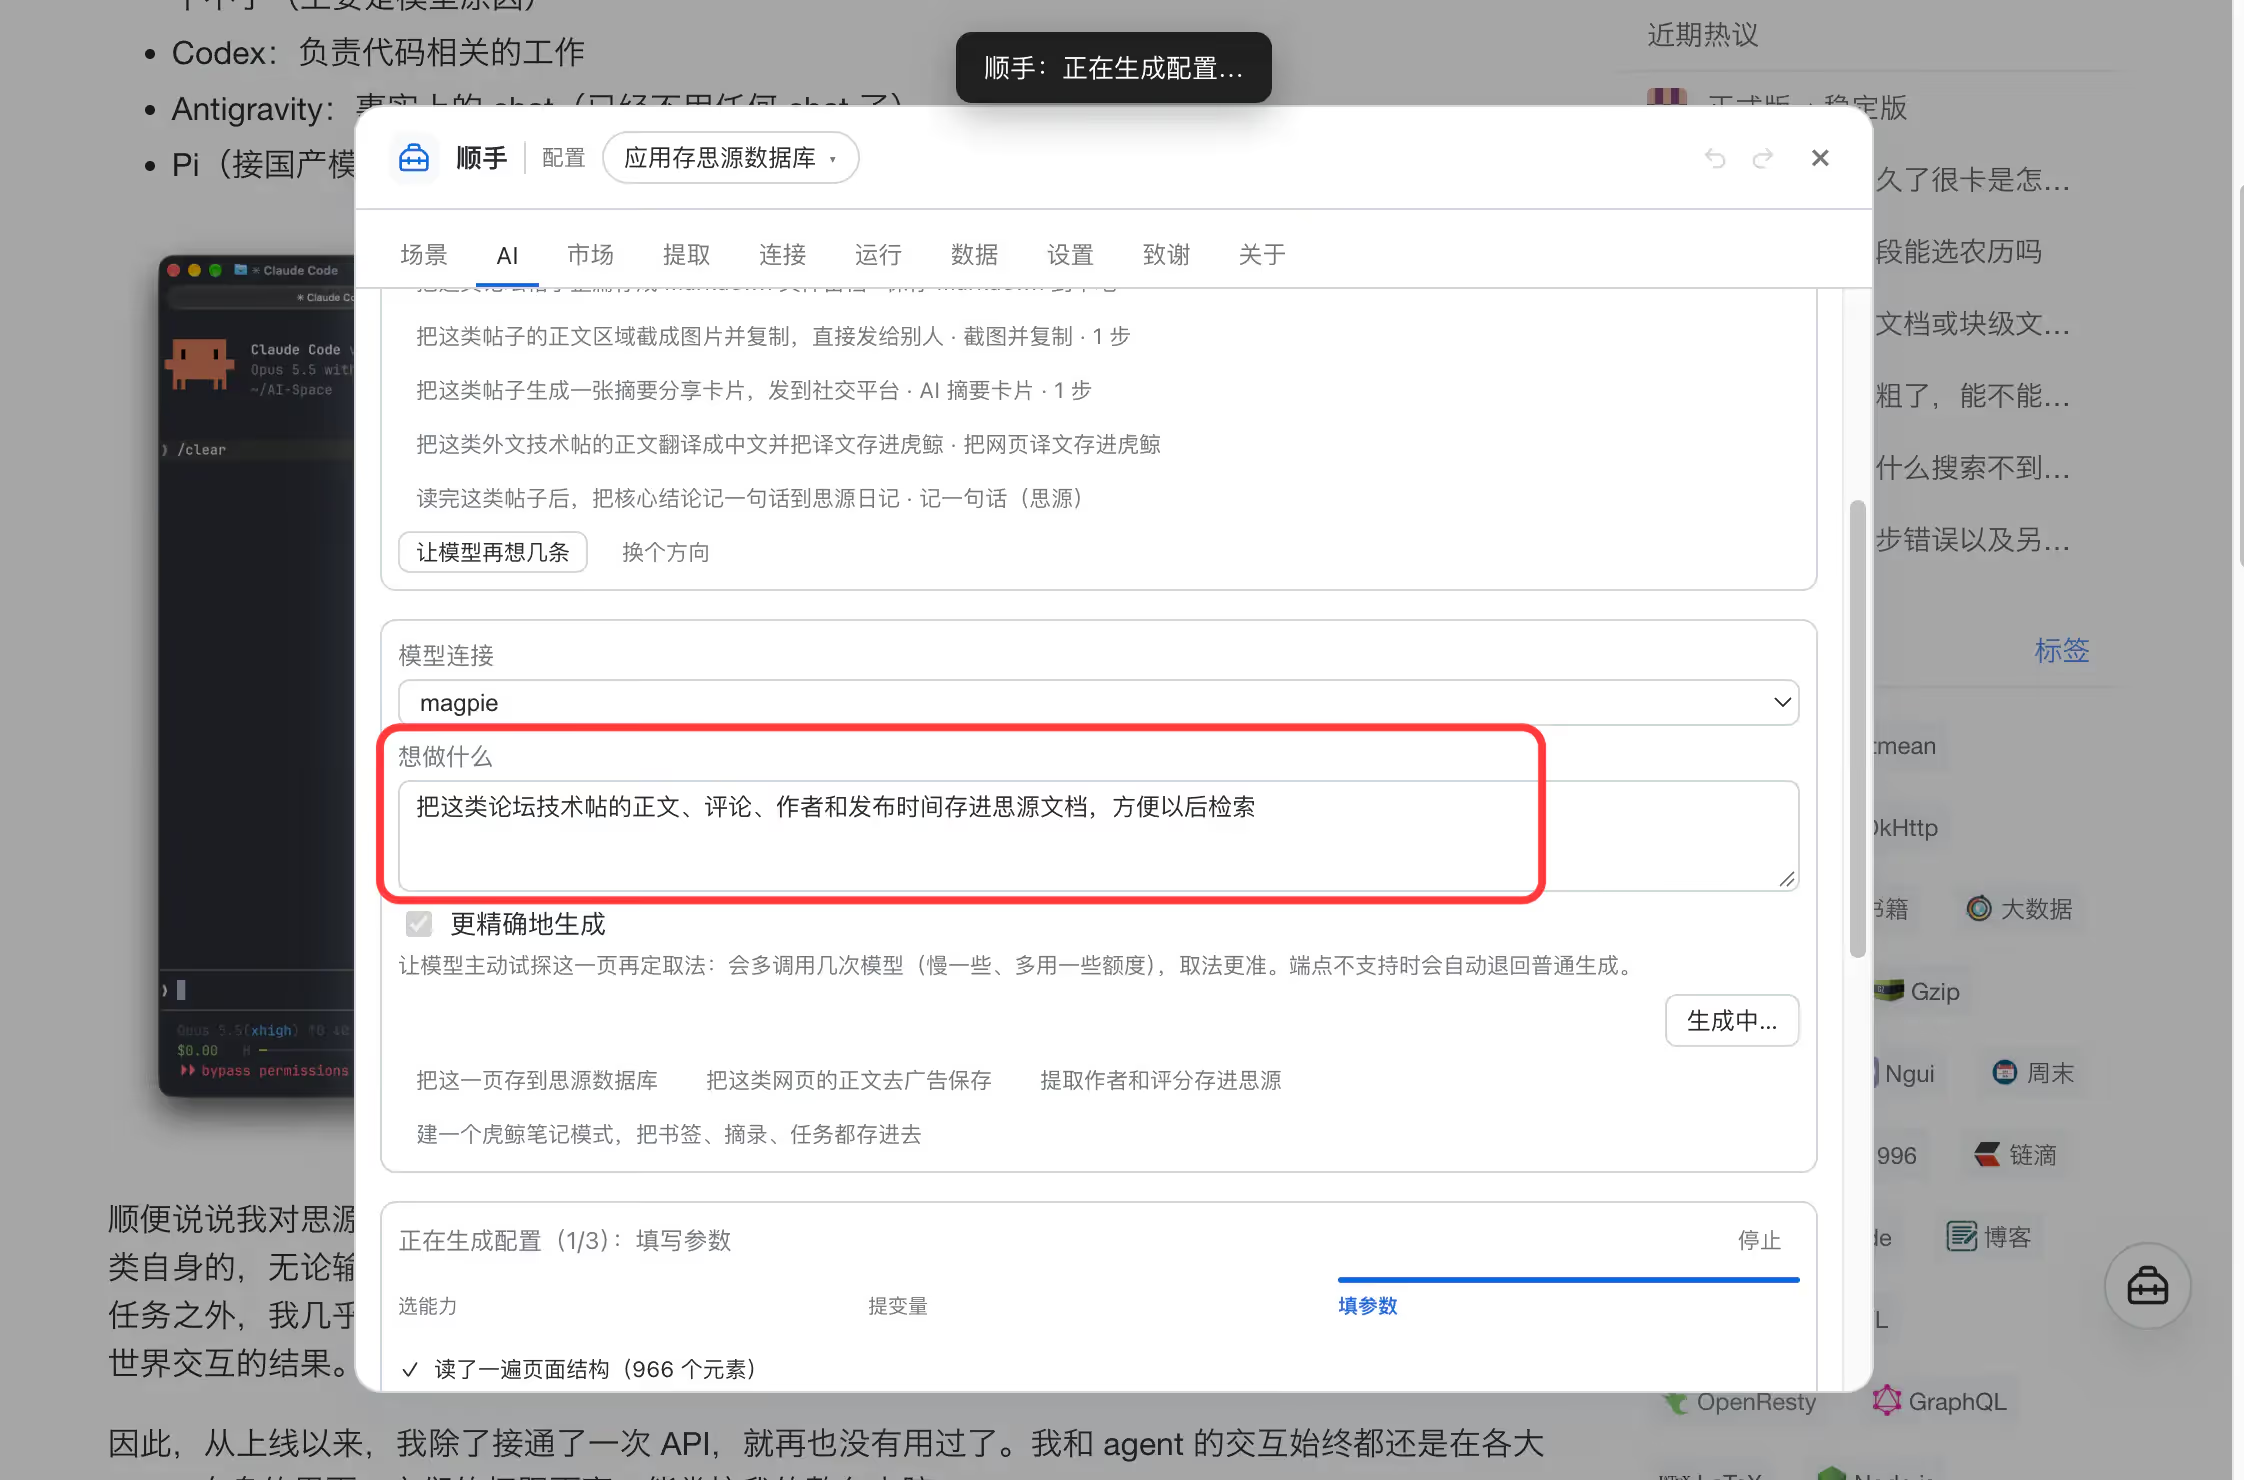
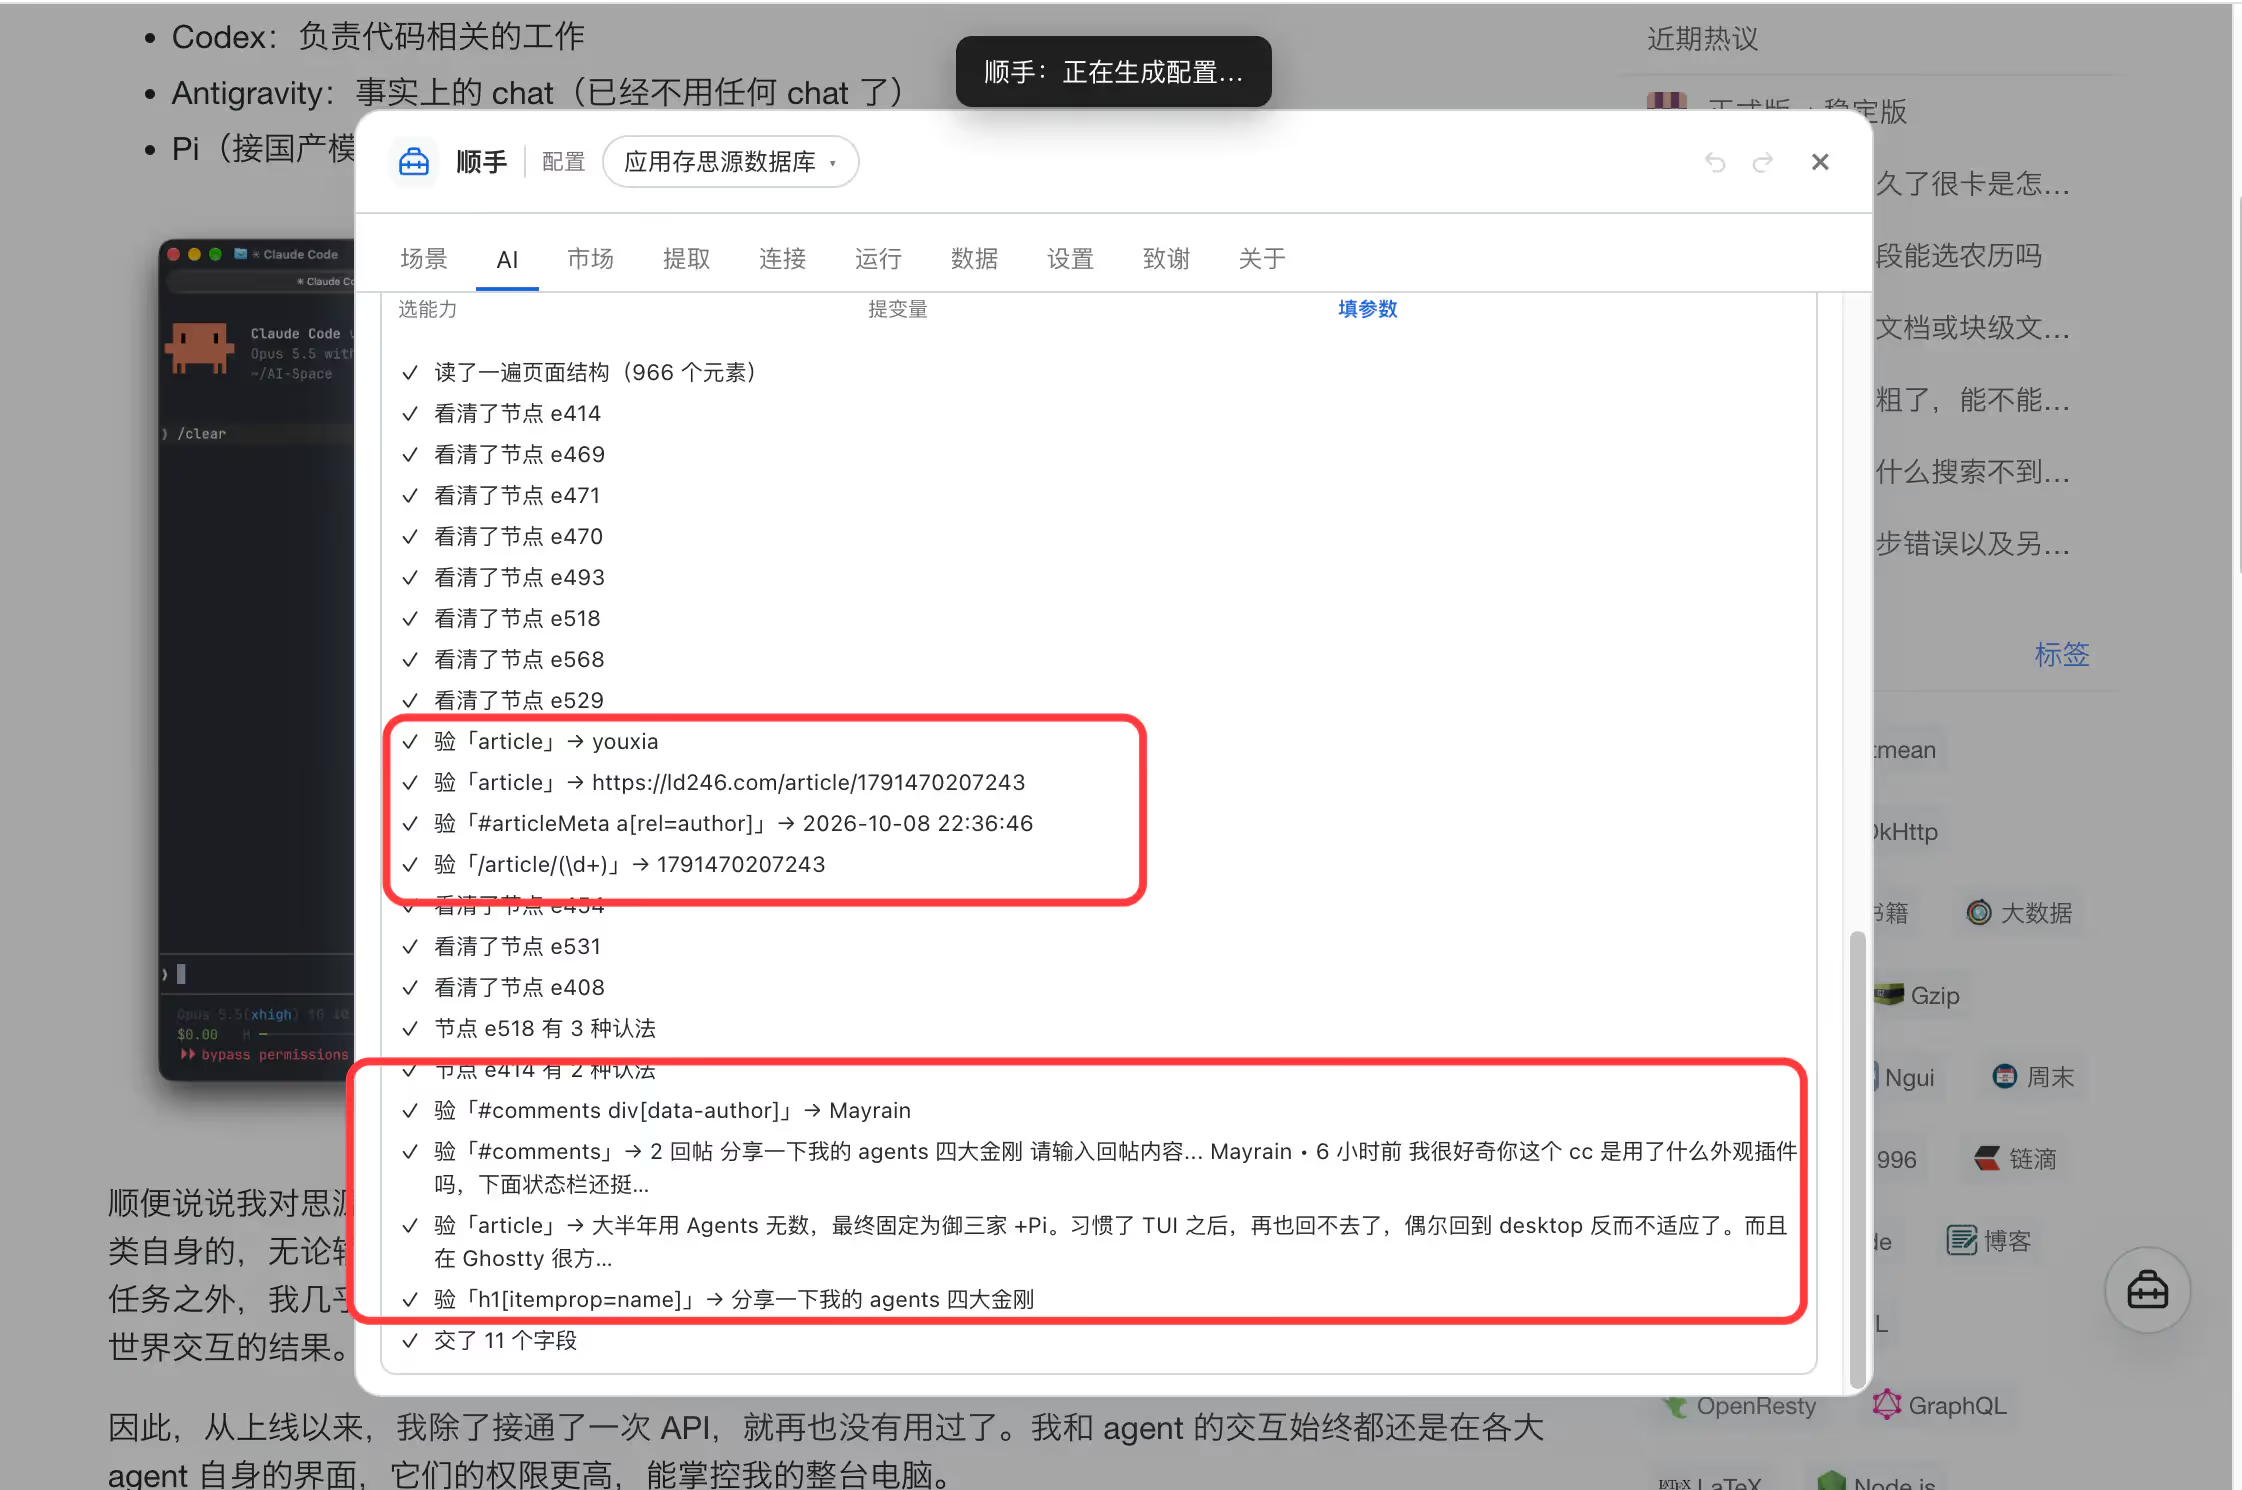
AI 进行分析,并创建动作
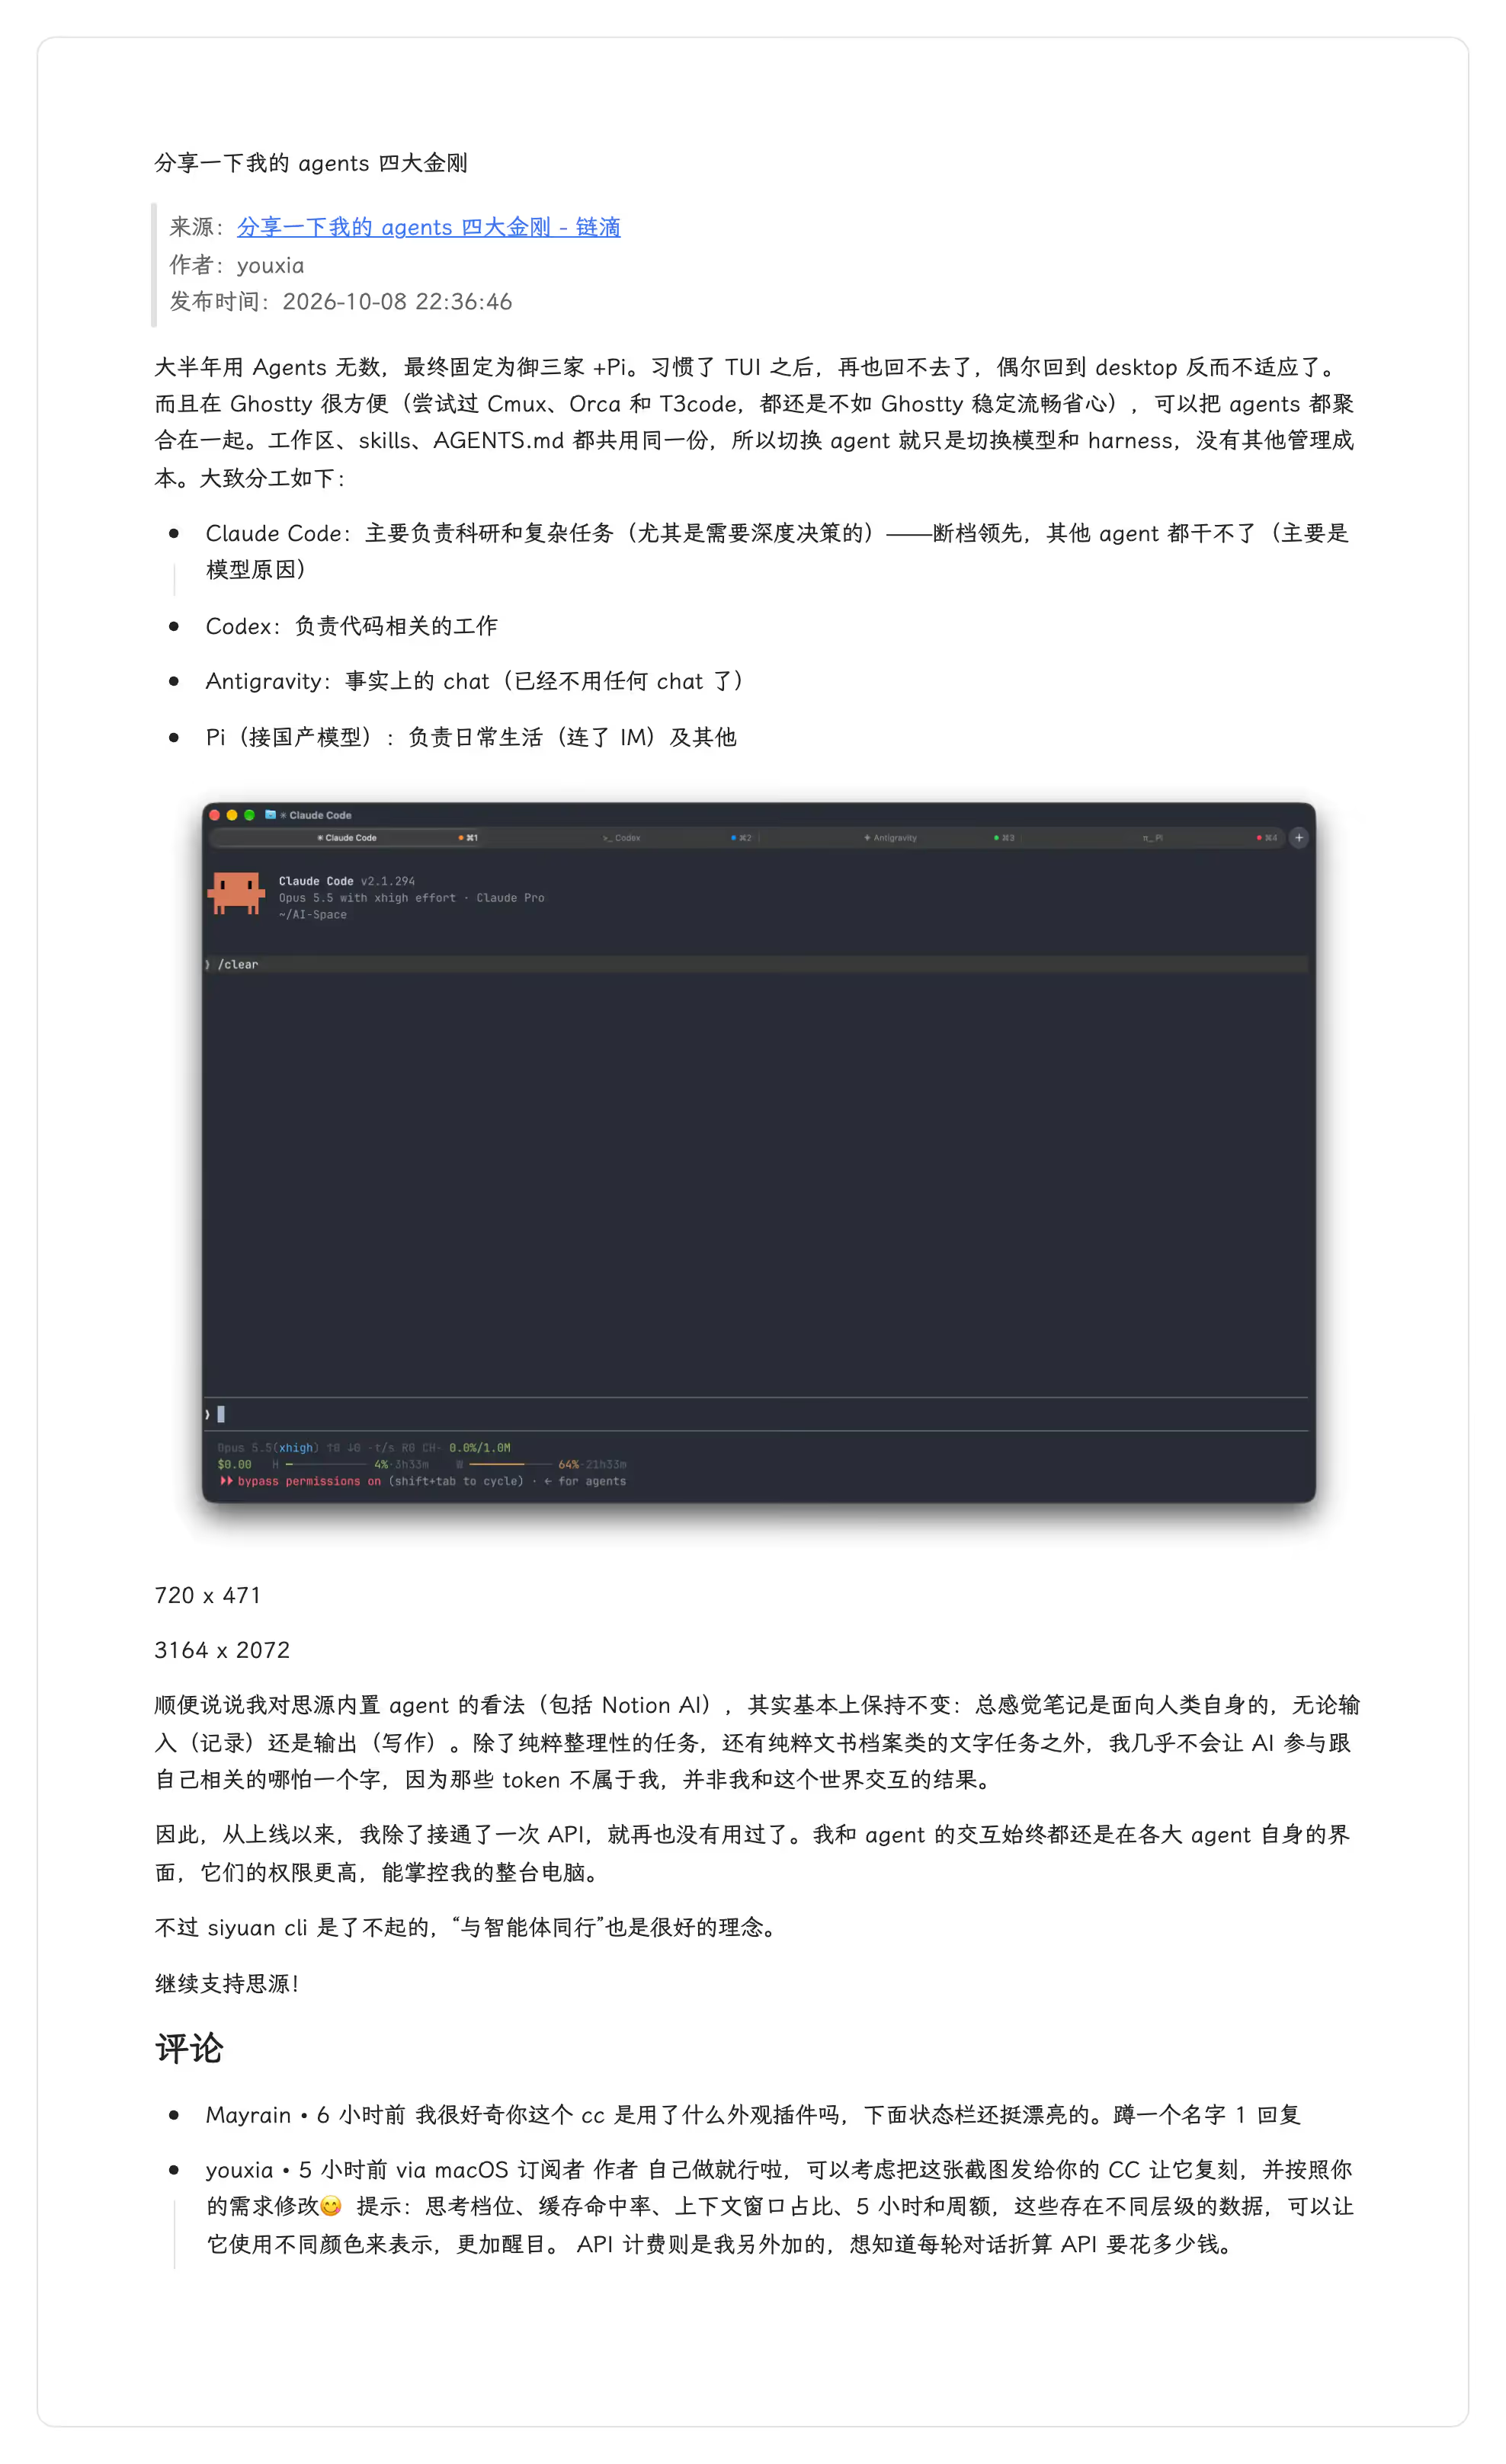
剪藏效果
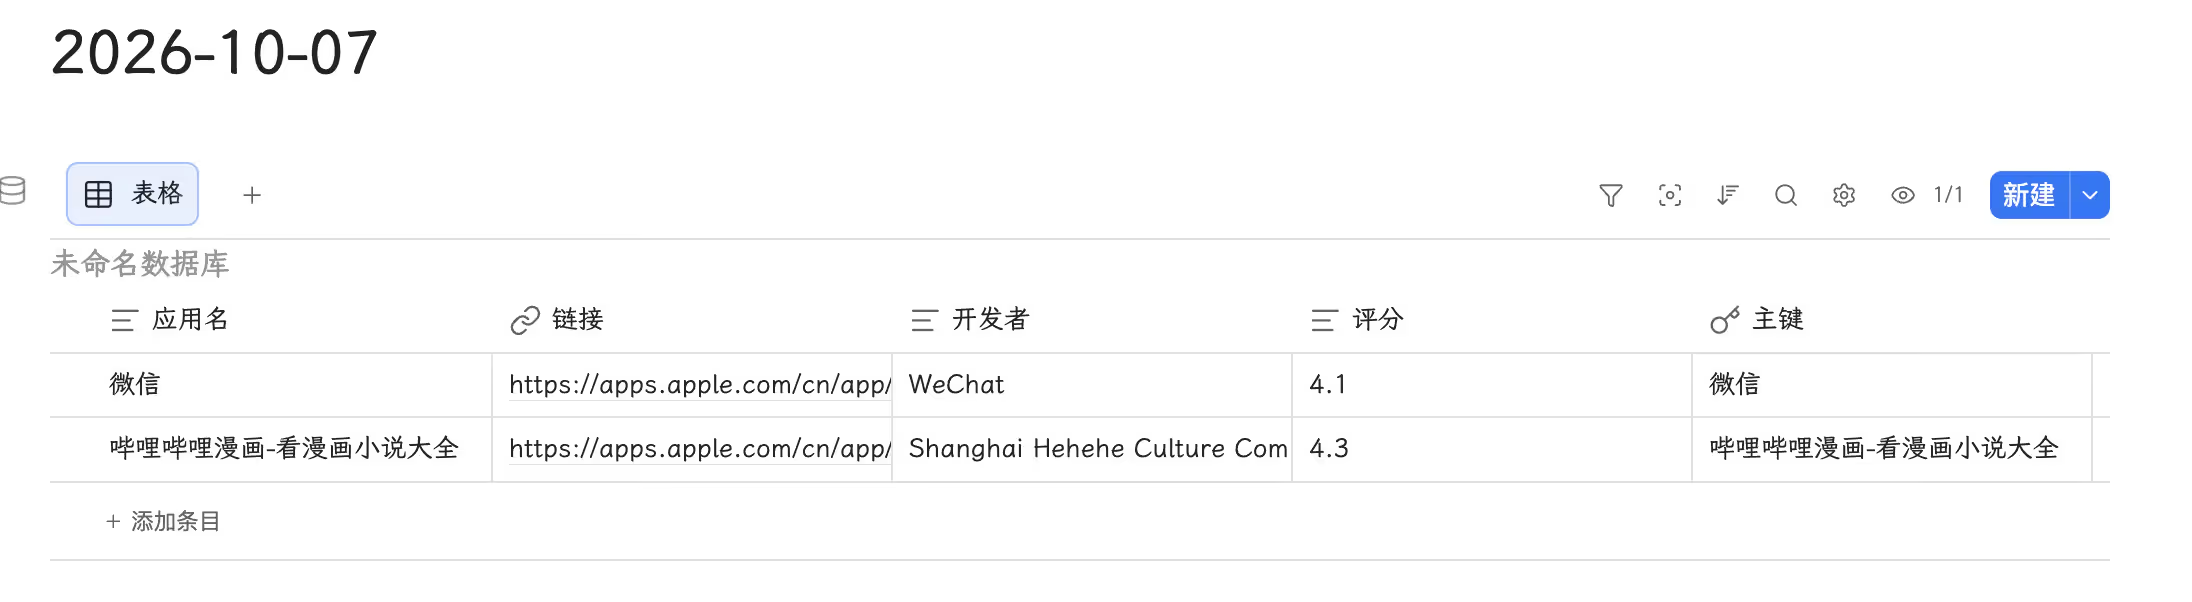
例二:将 Apple Store 的 App 获取元数据保存至思源笔记的数据库
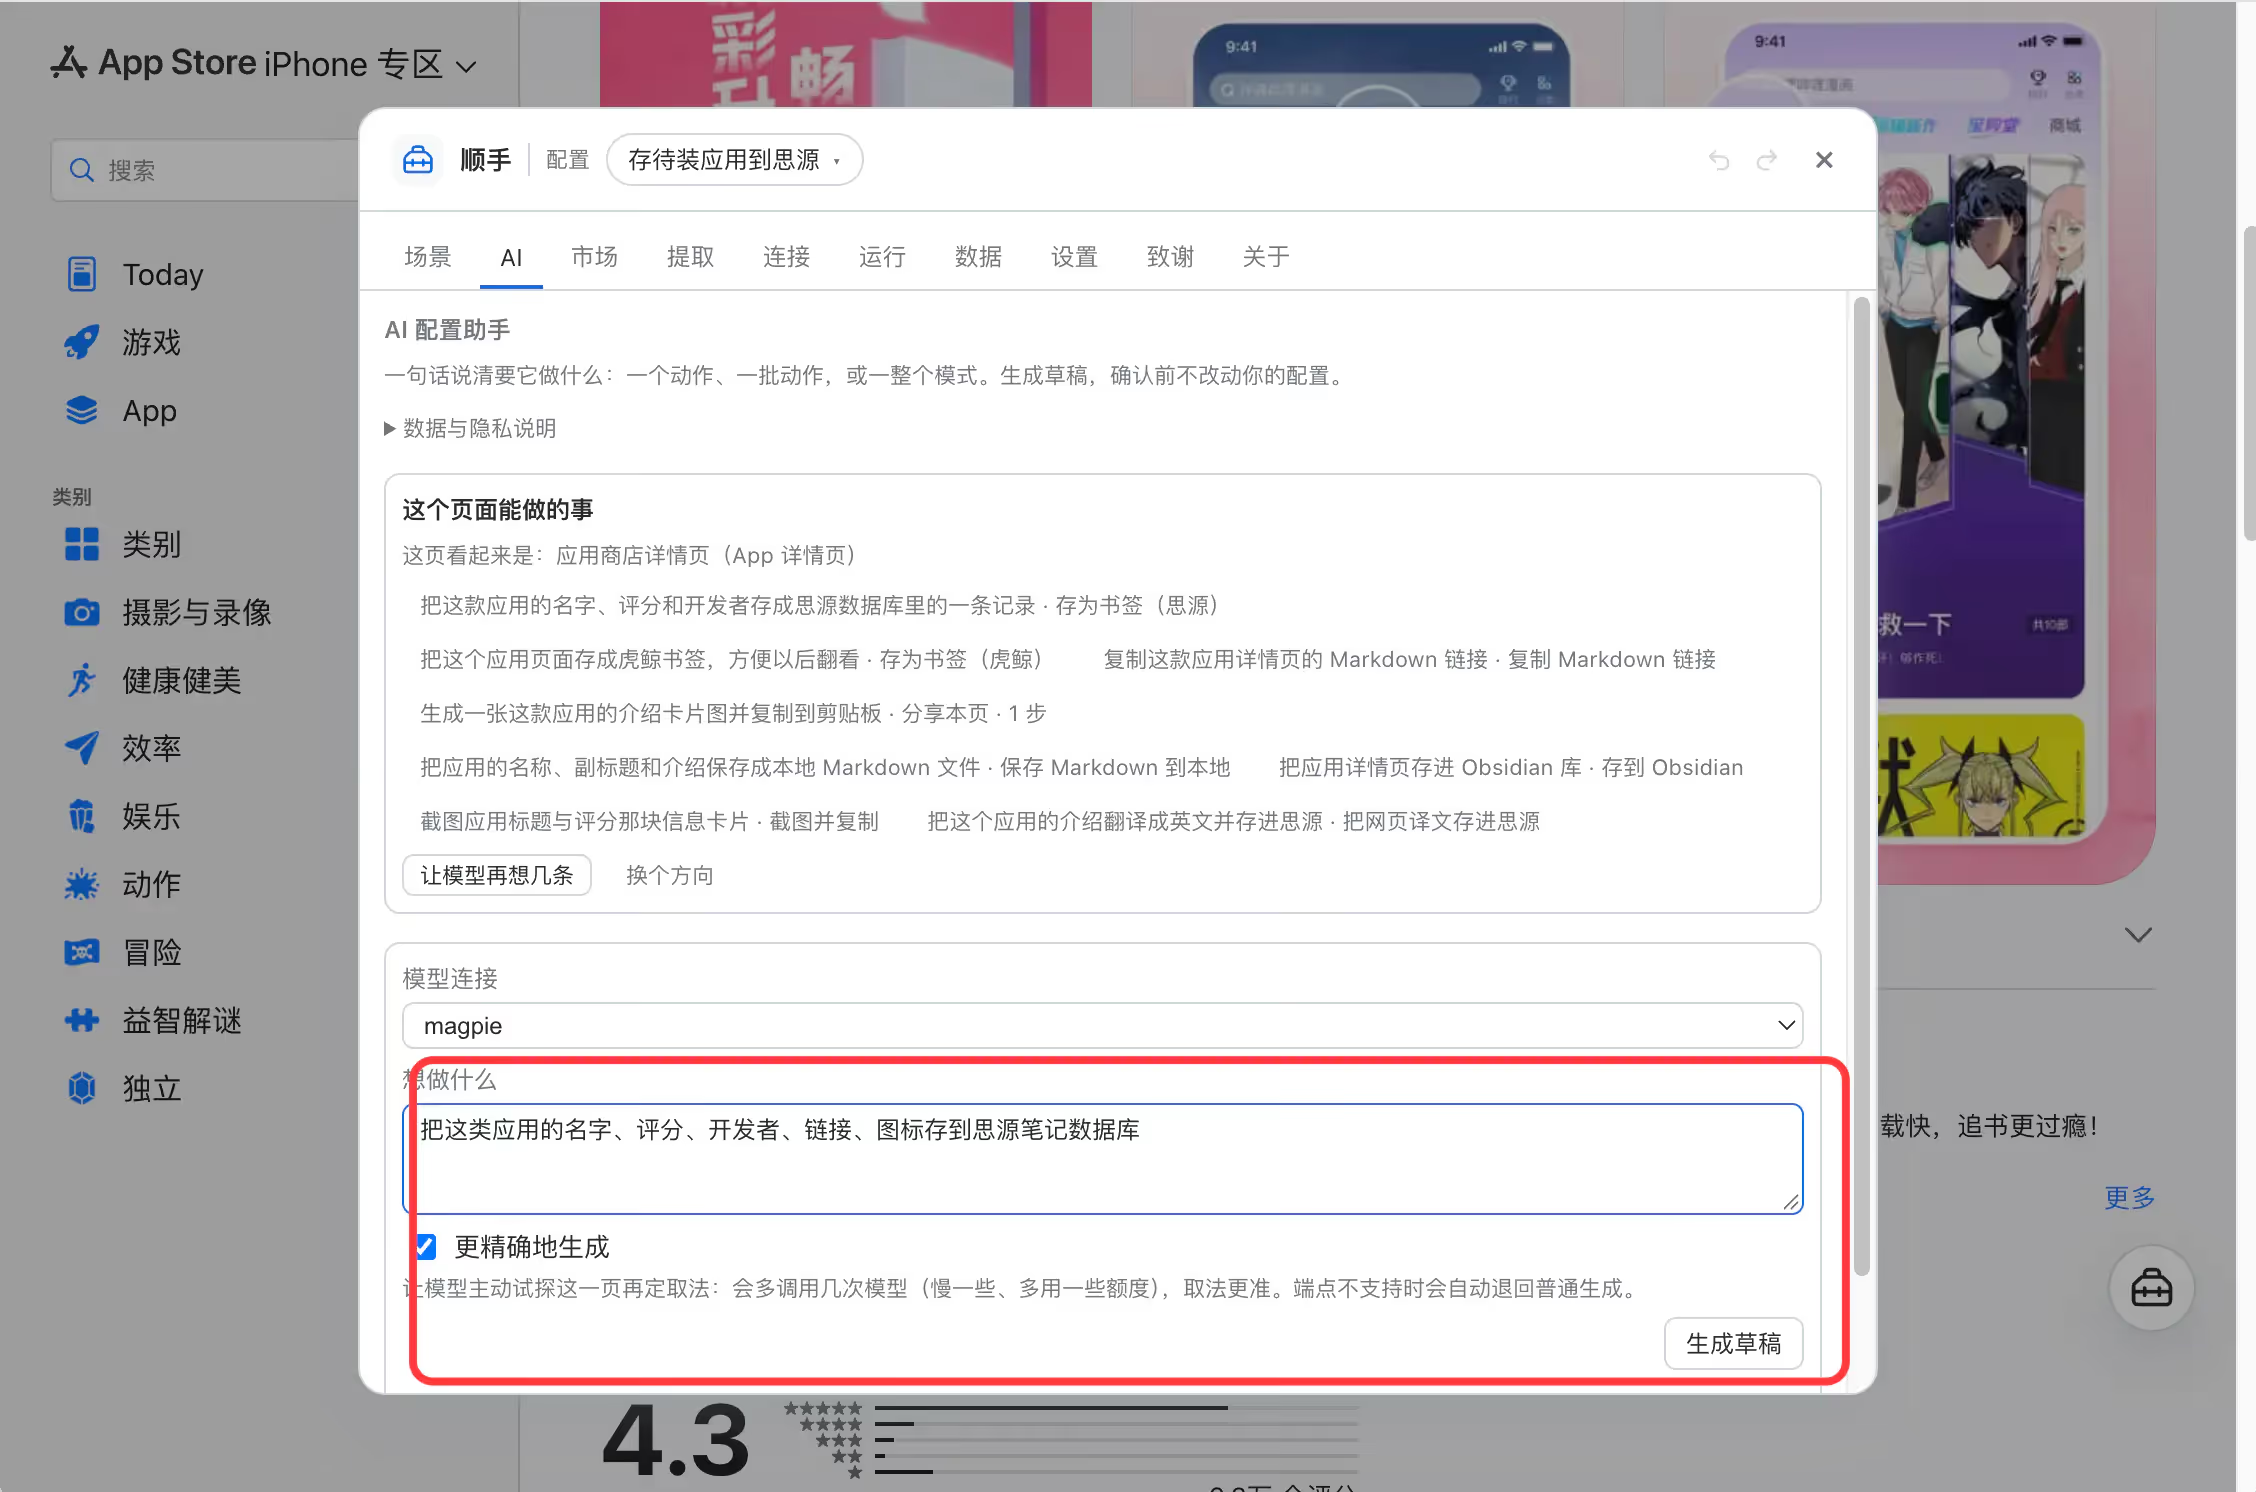
一句话
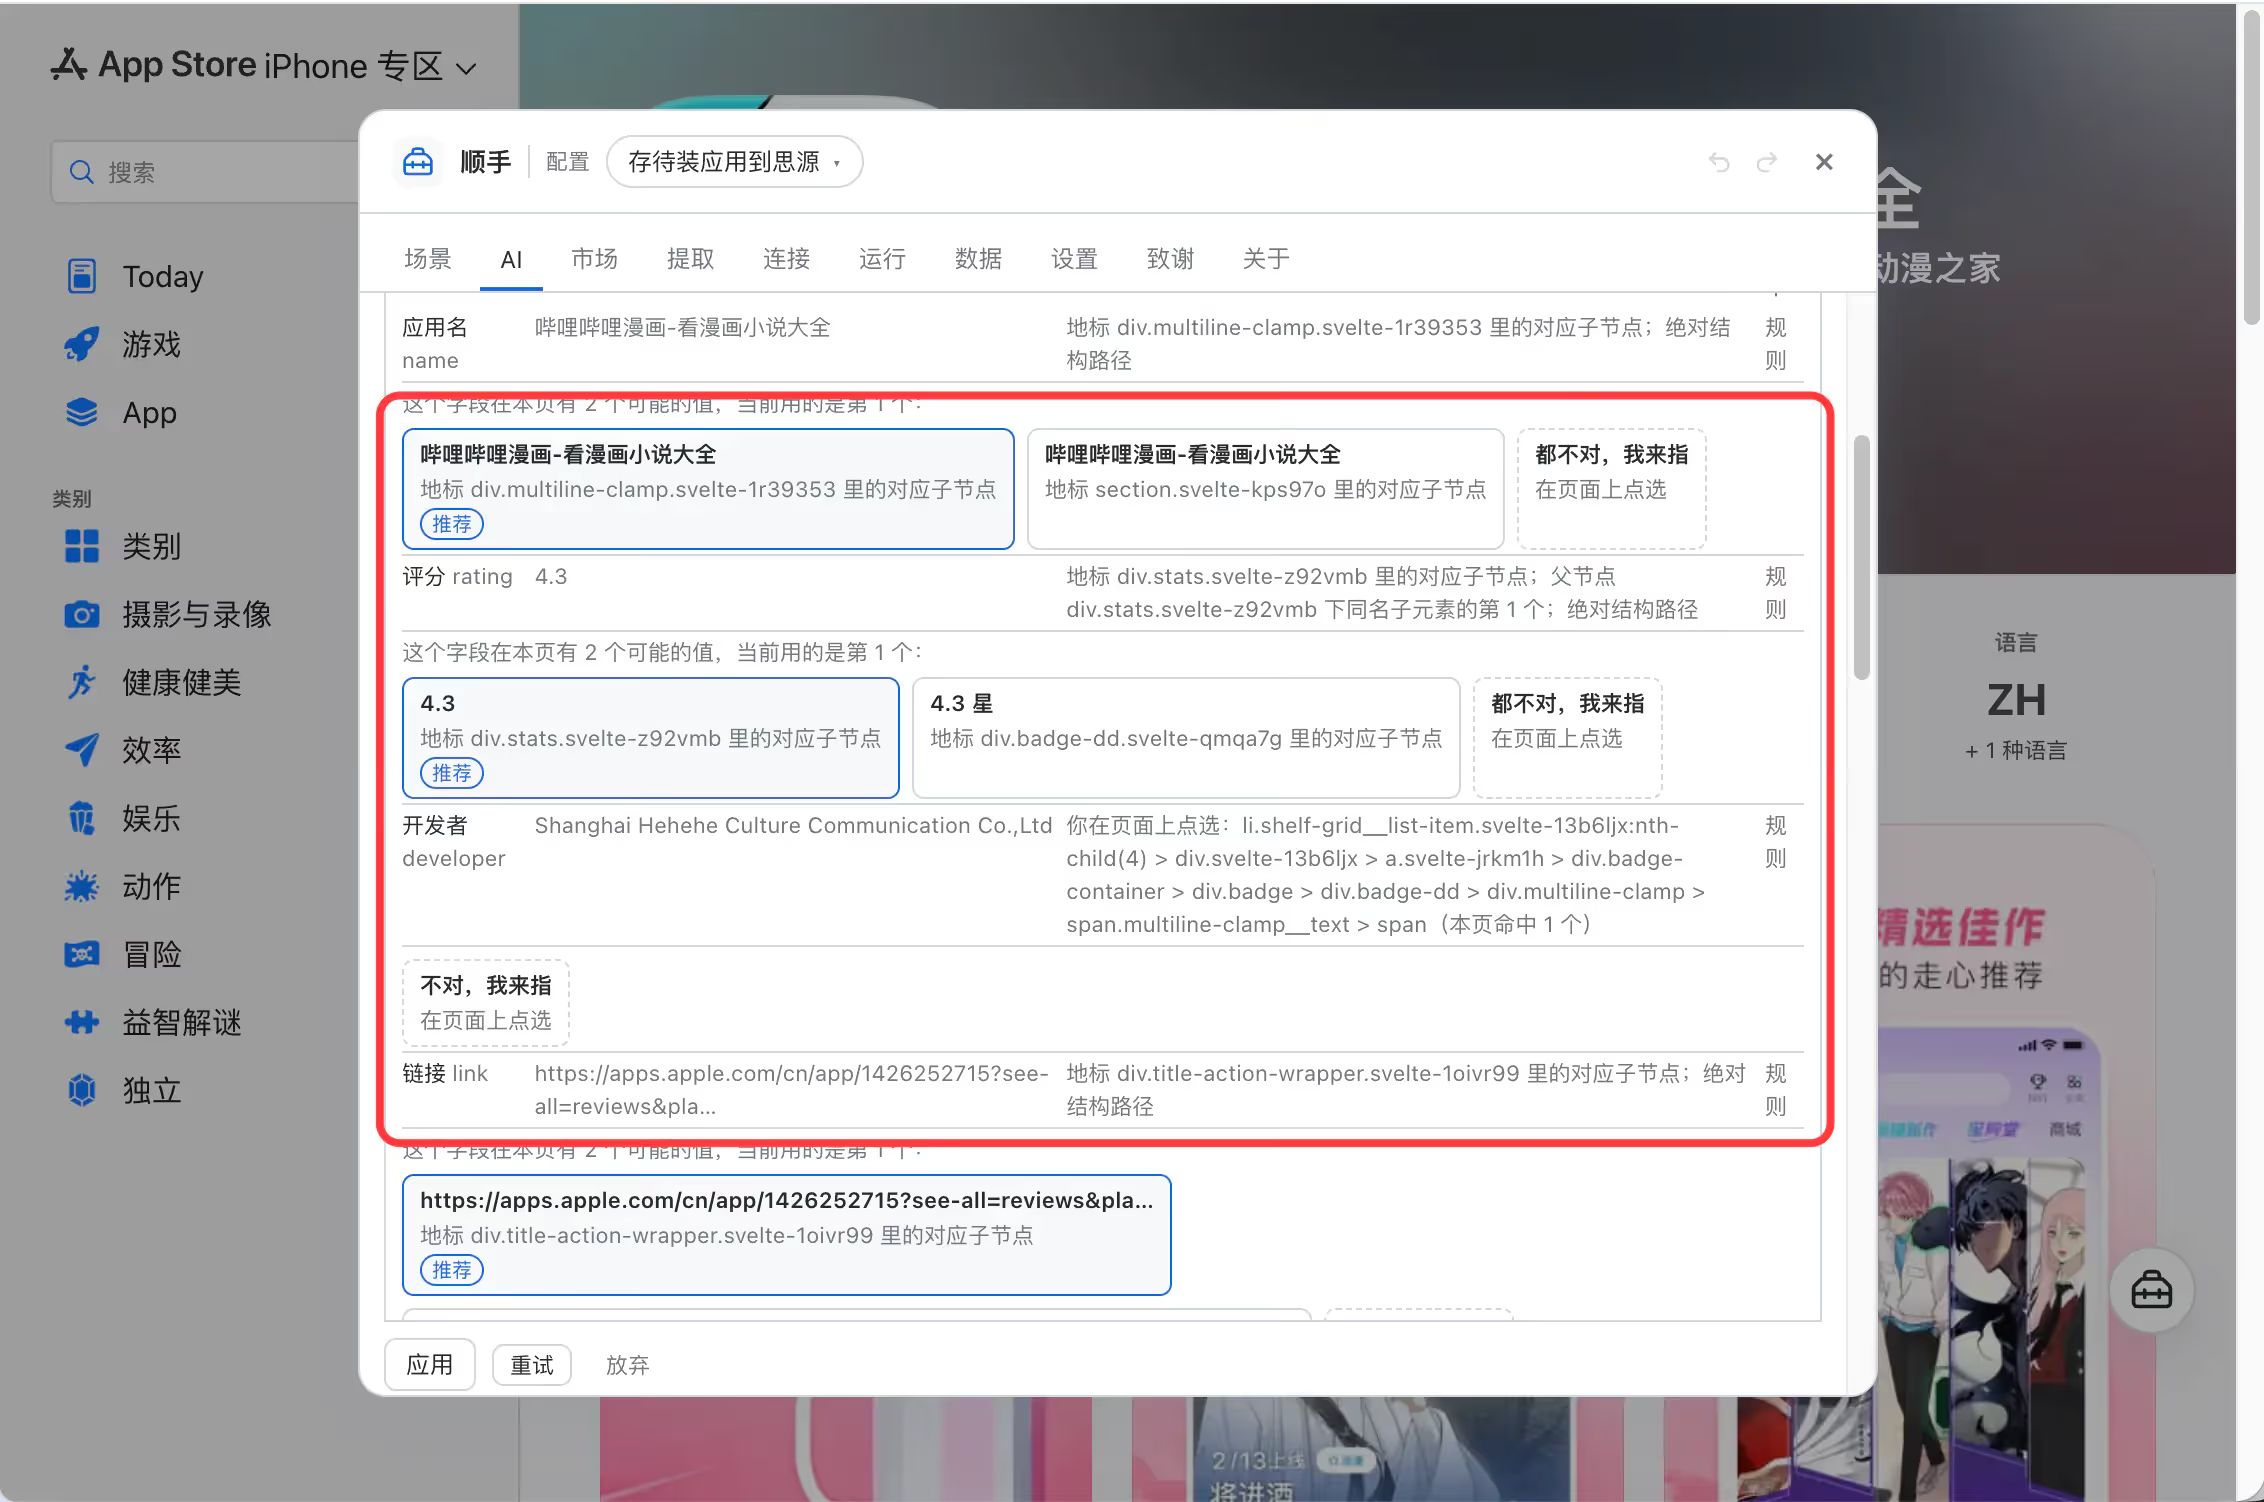
AI 分析出多个取值,可手动选择或者自己选择
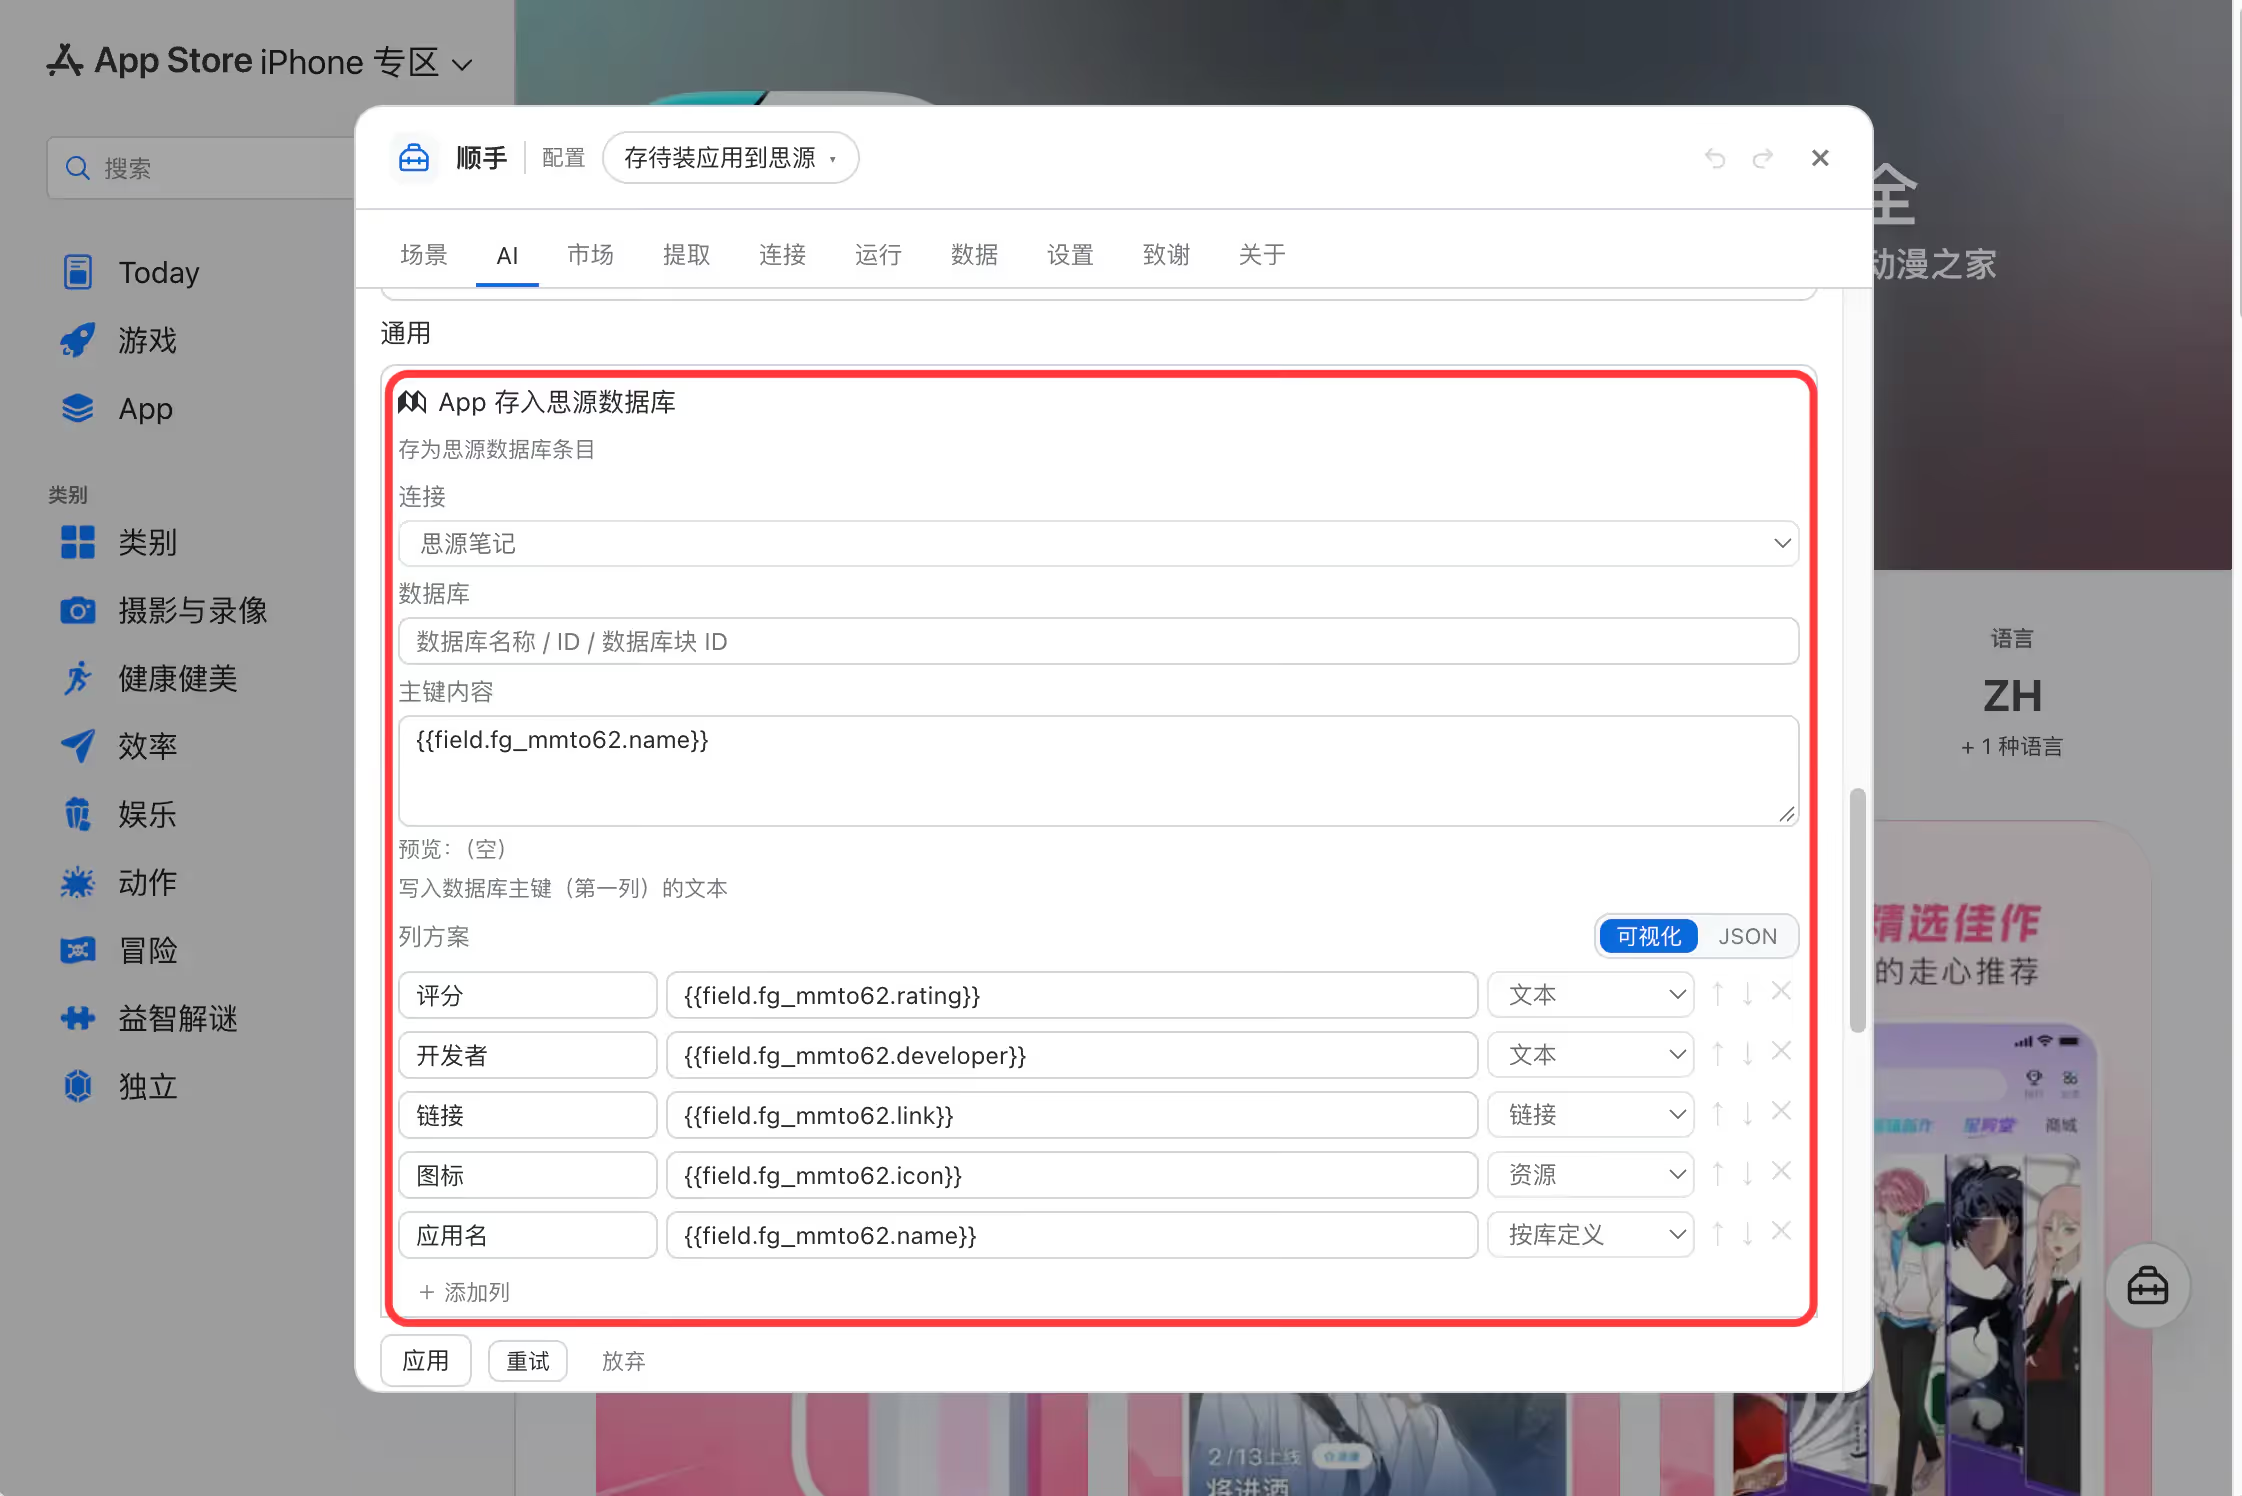
自动创建数据库列
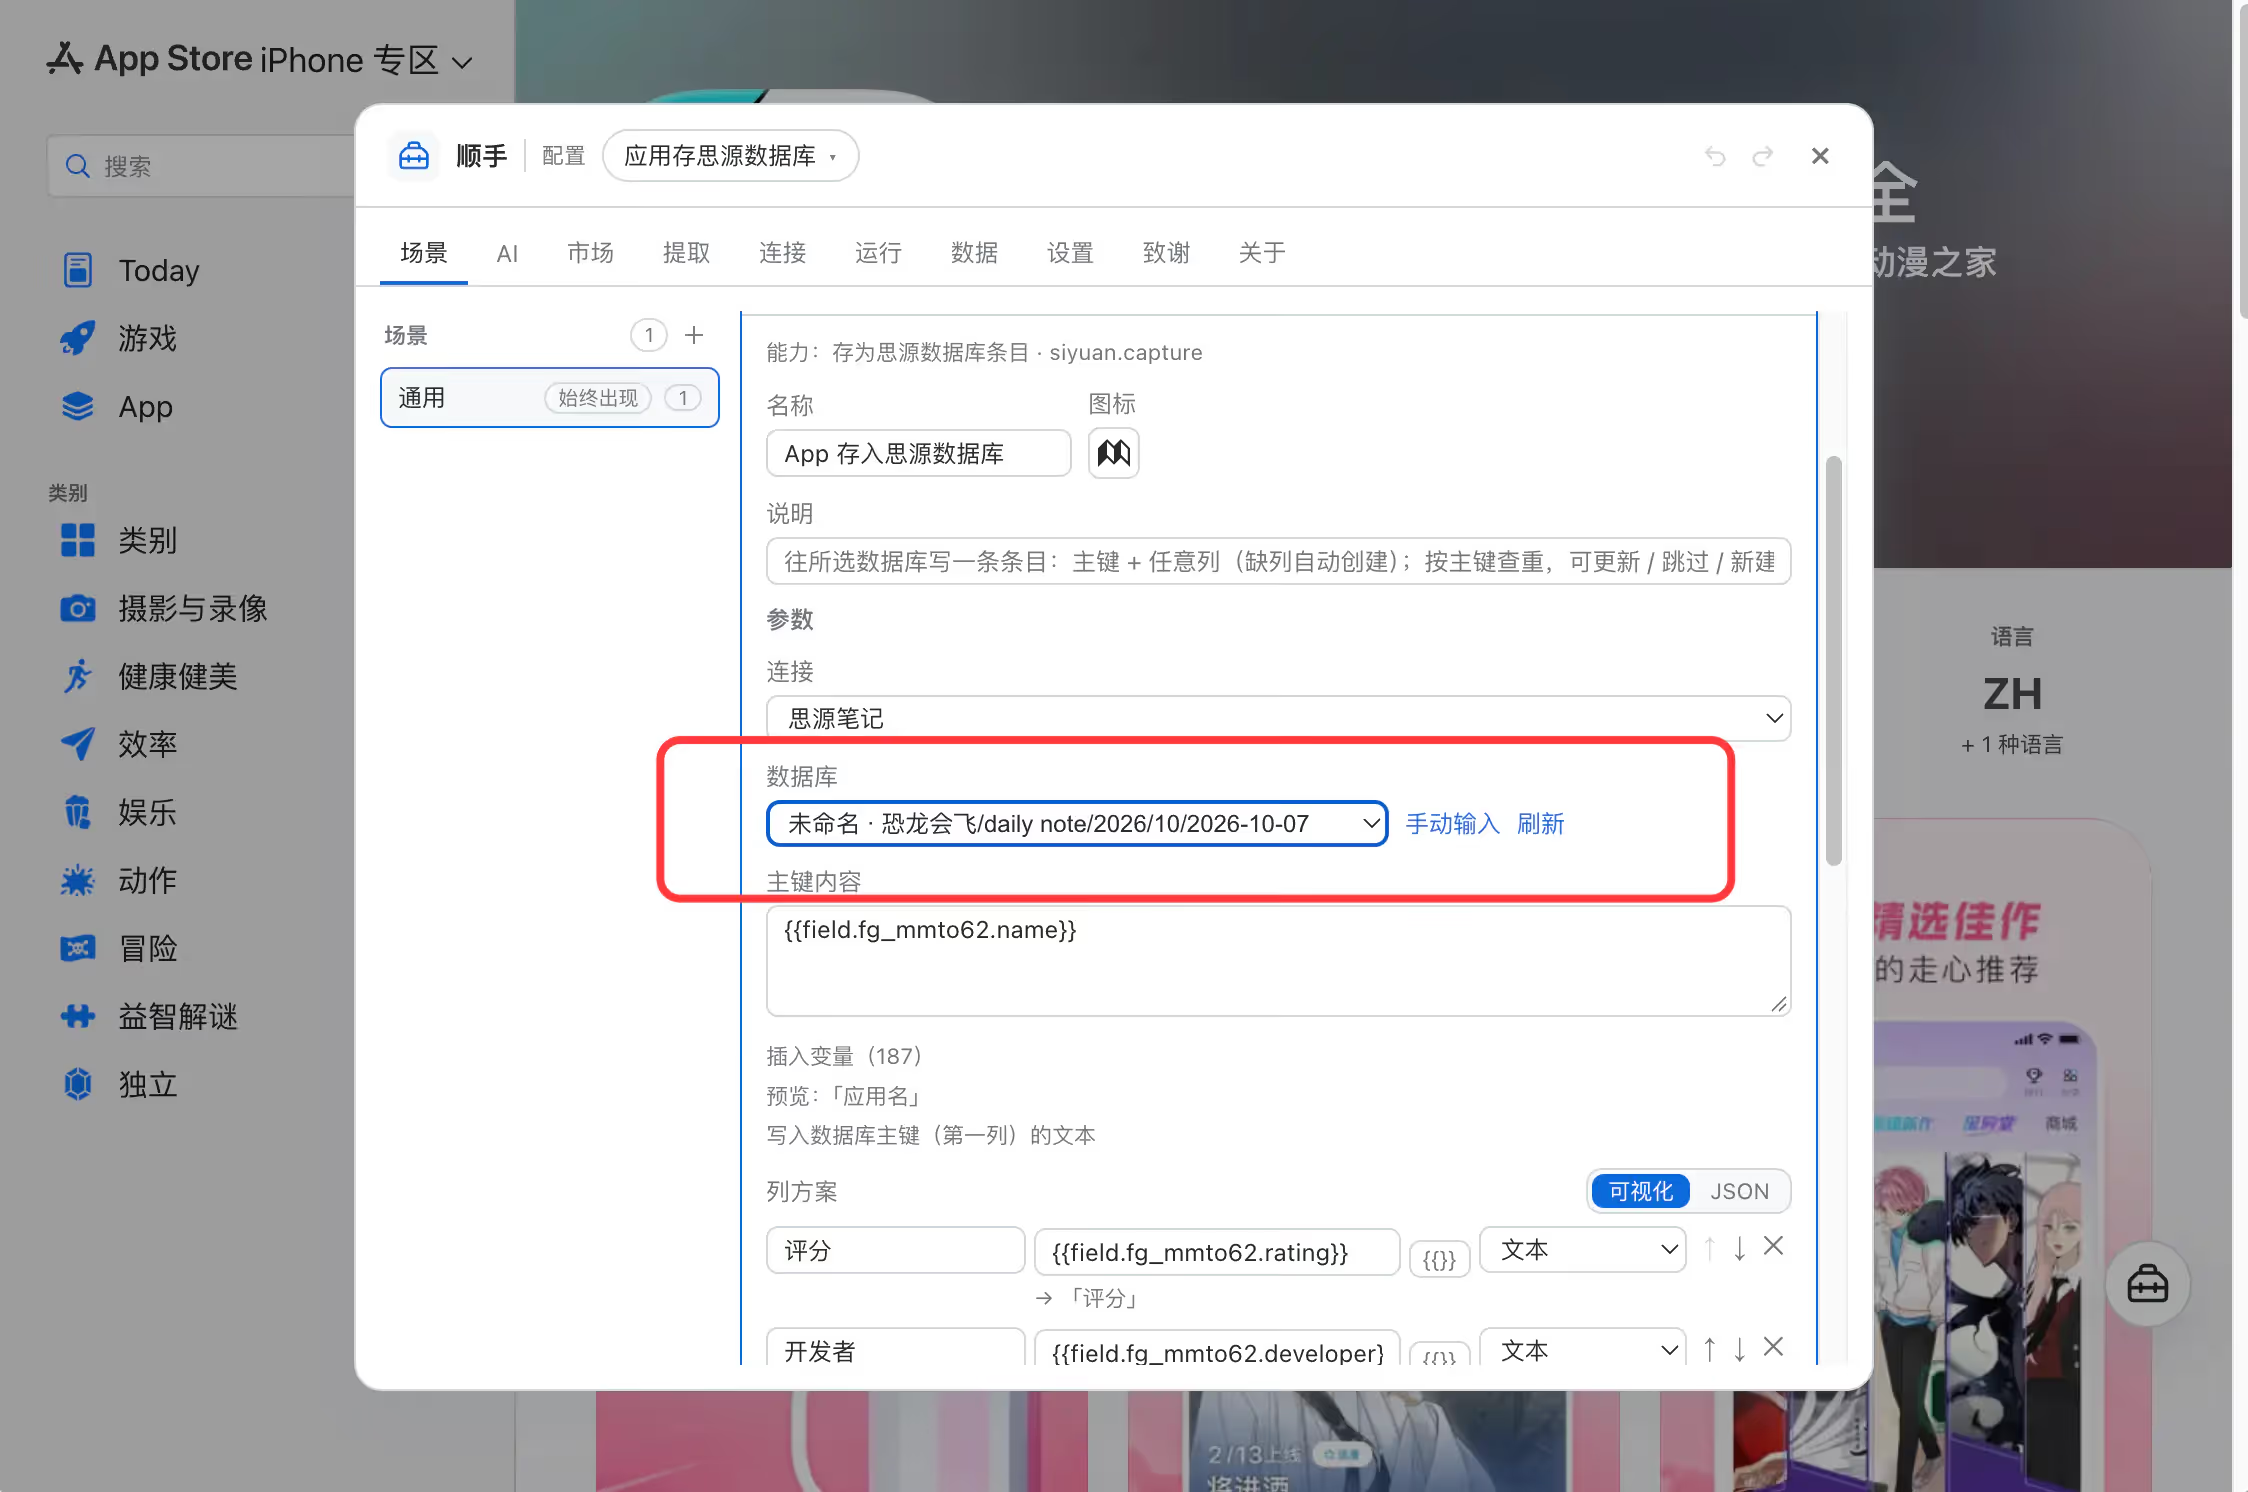
保存动作后配置选择下自己的数据库
效果
其它
我比较满意的是生成的规则抓取评论区效果还不错,除了例一里链滴社区的剪藏,比如这是 v2ex 帖子的剪藏: